Tipo: GitHub Repository
Link originale: https://github.com/deepseek-ai/DeepInfer
Data pubblicazione: 2026-10-22
Sintesi#
Introduzione#
Immagina di dover servire migliaia di richieste simultanee a un modello di linguaggio massivo come DeepSeek-V4.1-Flash. Non stiamo parlando di un chatbot che risponde a pochi utenti al giorno, ma di un sistema in produzione che deve gestire traffico reale, con latenze prevedibili e throughput consistente. Il problema? I framework di inference generici non sono costruiti per questo. Perdono tempo prezioso in overhead di scheduling, non sfruttano appieno l’hardware disponibile, e faticano a mantenere performance stabili quando il carico varia. DeepInfer è la risposta che DeepSeek ha sviluppato internamente per affrontare esattamente questo problema, e ora è disponibile come progetto open source.
DeepInfer non è un wrapper leggero attorno a vLLM o TensorRT-LLM. È un framework completamente ottimizzato, costruito dalle fondamenta per estrarre ogni goccia di performance dall’hardware moderno, sia esso GPU NVIDIA SM100 che NPU Huawei Ascend. Con quasi 20mila stelle su GitHub e una comunità attiva di contributor, rappresenta lo stato dell’arte nel campo dell’inference ad alta performance per modelli di linguaggio di grandi dimensioni.
Cosa Fa#
DeepInfer è essenzialmente il motore che trasforma un modello di linguaggio in un servizio di produzione affidabile e veloce. Prende il tuo modello DeepSeek, lo carica in memoria, e lo prepara a elaborare migliaia di token al secondo mantenendo latenze basse e prevedibili.
Il framework gestisce due fasi critiche dell’inference: il prefill (quando elabori il prompt iniziale) e il decode (quando generi i token di risposta uno per uno). Ognuna di queste fasi ha dinamiche completamente diverse, e DeepInfer le ottimizza separatamente. Durante il prefill, il sistema può parallelizzare massicciamente il lavoro perché tutti i token del prompt sono disponibili contemporaneamente. Durante il decode, invece, ogni token dipende dal precedente, quindi l’ottimizzazione si concentra su latenza ultra-bassa e throughput per utente.
Quello che rende DeepInfer speciale è come orchestestra tutto questo. Utilizza kernel ottimizzati custom (FlashMLA, DeepGEMM, DeepEP), implementa parallelismo sofisticato con attention data parallelism e expert parallelism per i modelli MoE, e introduce tecniche innovative come DSpark (draft tokens con verifica confidence-scheduled) per accelerare ulteriormente il decode. Il tutto è coordinato da uno scheduler asincrono a zero overhead che sovrappone il lavoro CPU con l’esecuzione GPU, eliminando i colli di bottiglia tradizionali.
Perché È Straordinario#
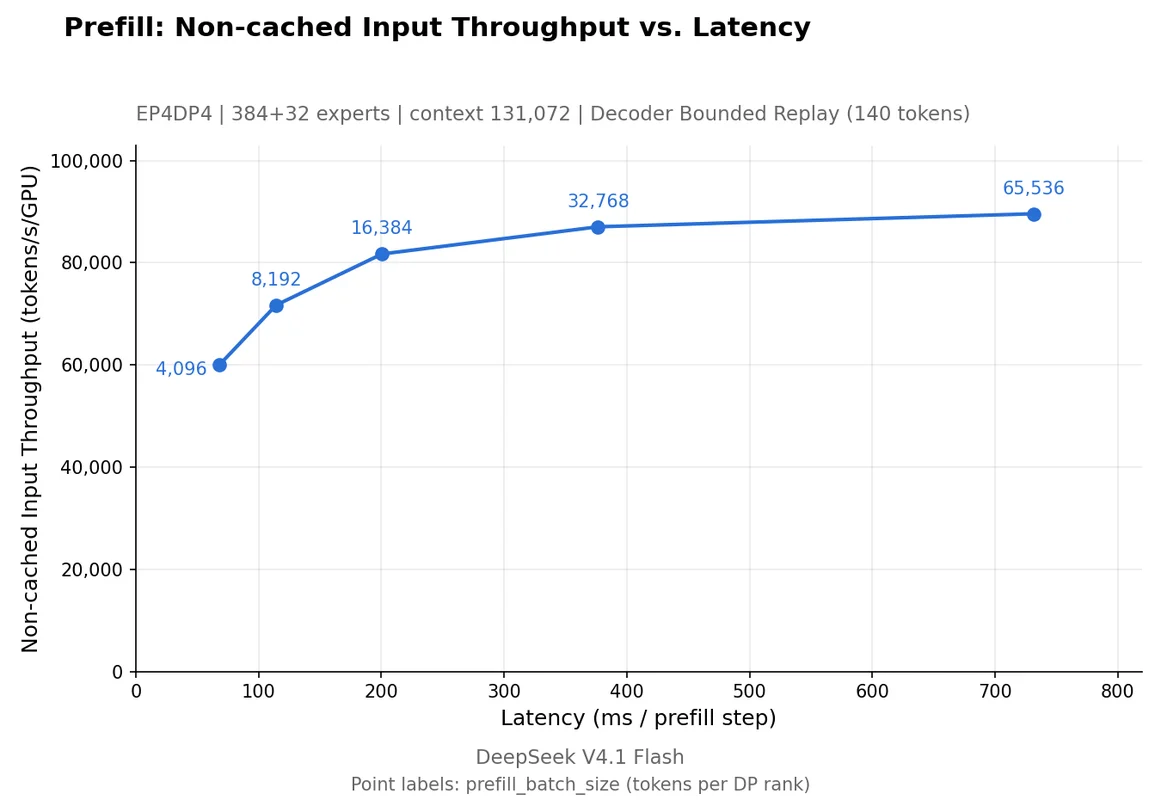
Il fattore “wow” di DeepInfer sta nella combinazione di performance bruta e affidabilità. I benchmark mostrano curve Pareto impressionanti: puoi scegliere se prioritizzare throughput massimo durante il prefill o latenza minima per il decode, e il framework ti permette di navigare questo trade-off in modo granulare. Ma non è solo velocità grezza.
Determinismo e riproducibilità: Una caratteristica spesso sottovalutata ma critica in produzione. DeepInfer può garantire che identici input e parametri di sampling producano identici output, indipendentemente dalla composizione del batch. Questo è fondamentale per debugging, testing e compliance. Abiliti semplicemente DEEPINFER_BATCH_INVARIANT=1 e il sistema mantiene la coerenza anche quando il carico varia.
Decoding intelligente con DSpark: Invece di generare ogni token sequenzialmente (lento), DeepInfer genera token “draft” in parallelo e poi verifica se sono corretti usando confidence estimates. Se la confidence è alta, il token viene accettato direttamente. Se è bassa, viene rigettato e rigenerato. Questo riduce drasticamente il numero di forward pass necessari, accelerando il decode di un fattore significativo senza compromettere la qualità.
Output strutturati: Puoi vincolare la generazione a regex, JSON schema o grammatiche EBNF. Questo significa che il modello non genererà mai output malformati. Se chiedi un JSON, ottieni un JSON valido. Se chiedi un numero tra 1 e 100, il modello non genererà mai 150. È una feature che semplifica enormemente l’integrazione in pipeline complesse.
Parallelismo sofisticato: DeepInfer implementa attention data parallelism, expert parallelism per i modelli MoE, e balanced context parallelism. Non è un semplice “dividi il batch tra GPU”. È un orchestramento intelligente che capisce la struttura del modello e distribuisce il carico in modo ottimale. Su 64 GPU per il decode, questo si traduce in throughput per utente che rimane stabile anche con migliaia di richieste simultanee.
Scheduling asincrono: Tradizionalmente, il CPU prepara il batch, lo invia alla GPU, aspetta che finisca, poi prepara il prossimo batch. DeepInfer sovrappone queste operazioni. Mentre la GPU elabora il batch corrente, il CPU prepara già il prossimo. Questo elimina i gap di inattività e riduce la latenza end-to-end.
Come Provarlo#
DeepInfer è disponibile su GitHub all’indirizzo github.com/deepseek-ai/DeepInfer. Il setup richiede un ambiente Linux con Python 3.12, GCC >= 13.0, e CUDA 13 (per NVIDIA) o CANN 9.2 (per Ascend). Non è una demo one-click, ma il processo è ragionevolmente diretto.
Dopo aver clonato il repository, crei un ambiente Python 3.12 vuoto, esporti la variabile DEEPINFER_ACCELERATOR=nvidia (o ascend se usi Huawei), e esegui ./build.sh. Il sistema scaricherà automaticamente il checkpoint DeepSeek-V4.1-Flash da Hugging Face al primo avvio, oppure puoi puntare a una copia locale via DEEPINFER_HF_MODEL_DIR. La documentazione nel repository include esempi di inference offline e script per riprodurre i benchmark ufficiali su 4 GPU per il prefill e 64 per il decode.
Per chi vuole approfondire, il repository contiene anche codice di evaluation e documentazione dettagliata su come configurare le varie feature (DSpark, batch-invariant inference, structured outputs). La community è attiva nel rispondere a domande, e il codice è ben strutturato per chi vuole contribuire o estendere il framework.
Considerazioni Finali#
DeepInfer rappresenta un momento importante nell’evoluzione dell’ecosistema open source per l’AI. Non è solo un tool, è la materializzazione di anni di ricerca e ottimizzazione da parte di DeepSeek, resa disponibile alla comunità. In un momento in cui i modelli di linguaggio stanno diventando sempre più grandi e le richieste di inference sempre più complesse, avere accesso a un framework costruito per la produzione reale è prezioso.
Quello che rende questo progetto particolarmente interessante è che non è una semplificazione. DeepInfer mantiene la complessità necessaria per ottenere performance reali, ma la espone attraverso API ragionevoli. Se sei uno sviluppatore che vuole servire modelli DeepSeek in produzione, o un ricercatore interessato alle tecniche di ottimizzazione per l’inference, DeepInfer merita di essere nel tuo toolkit.
Casi d’uso#
- Private AI Stack: Integrazione in pipeline proprietarie
- Client Solutions: Implementazione per progetti clienti
- Development Acceleration: Riduzione time-to-market progetti
Risorse#
Link Originali#
Articolo segnalato e selezionato dal team Human Technology eXcellence elaborato tramite intelligenza artificiale (in questo caso con LLM HTX-EU-Claude-Haiku-4.5) il 2026-10-22 13:13 Fonte originale: https://github.com/deepseek-ai/DeepInfer
Articoli Correlati#
- GitHub - HandsOnLLM/Hands-On-Large-Language-Models: Official code repo for the O’Reilly Book - ‘Hands-On Large Language Models’ - LLM, Open Source, Foundation Model
- GitHub - antirez/voxtral.c: Pure C inference of Mistral Voxtral Realtime 4B speech to text model - Natural Language Processing, Foundation Model, Open Source
- GitHub - jundot/omlx: LLM inference server with continuous batching & SSD caching for Apple Silicon — managed from the mac - Machine Learning, LLM, Python