Type: GitHub Repository
Lien original: https://github.com/deepseek-ai/DeepInfer
Date de publication: 2026-10-22
Résumé#
Introduction#
Imaginez devoir servir des milliers de requêtes simultanées à un modèle de langage massif comme DeepSeek-V4.1-Flash. Nous ne parlons pas d’un chatbot répondant à quelques utilisateurs par jour, mais d’un système en production devant gérer du trafic réel, avec des latences prévisibles et un débit constant. Le problème ? Les frameworks d’inference génériques ne sont pas construits pour cela. Ils perdent du temps précieux en surcharge de planification, n’exploitent pas pleinement le matériel disponible, et ont du mal à maintenir des performances stables lorsque la charge varie. DeepInfer est la réponse que DeepSeek a développée en interne pour affronter exactement ce problème, et elle est maintenant disponible en tant que projet open source.
DeepInfer n’est pas un wrapper léger autour de vLLM ou TensorRT-LLM. C’est un framework complètement optimisé, construit de zéro pour extraire chaque goutte de performance du matériel moderne, qu’il s’agisse de GPU NVIDIA SM100 ou de NPU Huawei Ascend. Avec près de 20 000 étoiles sur GitHub et une communauté active de contributeurs, il représente l’état de l’art dans le domaine de l’inference haute performance pour les modèles de langage de grande taille.
Ce qu’il fait#
DeepInfer est essentiellement le moteur qui transforme un modèle de langage en un service de production fiable et rapide. Il prend votre modèle DeepSeek, le charge en mémoire, et le prépare à traiter des milliers de tokens par seconde tout en maintenant des latences basses et prévisibles.
Le framework gère deux phases critiques de l’inference : le prefill (lorsque vous traitez l’invite initiale) et le decode (lorsque vous générez les tokens de réponse un par un). Chacune de ces phases a des dynamiques complètement différentes, et DeepInfer les optimise séparément. Pendant le prefill, le système peut paralléliser massivement le travail car tous les tokens de l’invite sont disponibles simultanément. Pendant le decode, en revanche, chaque token dépend du précédent, donc l’optimisation se concentre sur une latence ultra-basse et un débit par utilisateur.
Ce qui rend DeepInfer spécial, c’est la façon dont il orchestre tout cela. Il utilise des kernels optimisés personnalisés (FlashMLA, DeepGEMM, DeepEP), implémente un parallélisme sophistiqué avec attention data parallelism et expert parallelism pour les modèles MoE, et introduit des techniques innovantes comme DSpark (draft tokens avec vérification confidence-scheduled) pour accélérer davantage le decode. Tout cela est coordonné par un planificateur asynchrone à zéro surcharge qui chevauche le travail CPU avec l’exécution GPU, éliminant les goulots d’étranglement traditionnels.
Pourquoi c’est extraordinaire#
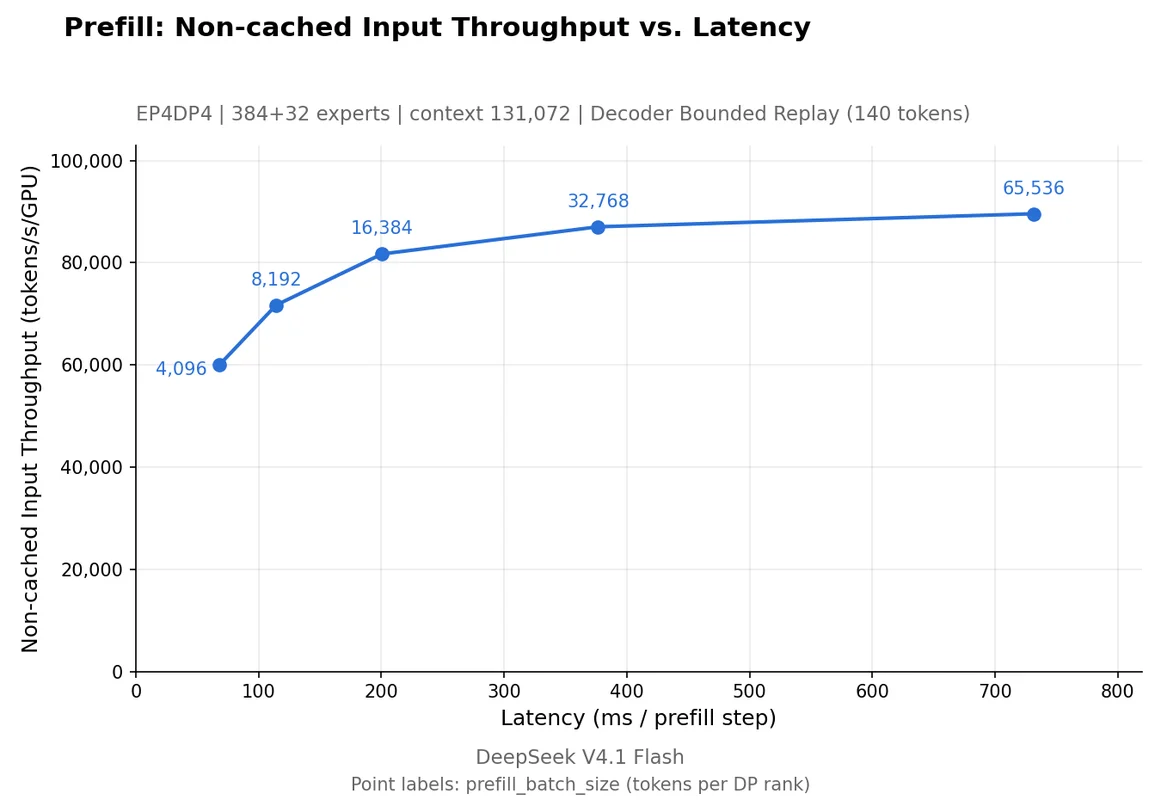
Le facteur « wow » de DeepInfer réside dans la combinaison de performance brute et de fiabilité. Les benchmarks montrent des courbes Pareto impressionnantes : vous pouvez choisir de prioriser le débit maximal pendant le prefill ou la latence minimale pour le decode, et le framework vous permet de naviguer ce compromis de manière granulaire. Mais ce n’est pas seulement de la vitesse brute.
Déterminisme et reproductibilité : Une caractéristique souvent sous-estimée mais critique en production. DeepInfer peut garantir que des entrées identiques et des paramètres d’échantillonnage identiques produisent des sorties identiques, indépendamment de la composition du batch. C’est fondamental pour le débogage, les tests et la conformité. Vous activez simplement DEEPINFER_BATCH_INVARIANT=1 et le système maintient la cohérence même lorsque la charge varie.
Décodage intelligent avec DSpark : Au lieu de générer chaque token séquentiellement (lent), DeepInfer génère des tokens « draft » en parallèle, puis vérifie s’ils sont corrects en utilisant des estimations de confiance. Si la confiance est élevée, le token est accepté directement. Si elle est basse, il est rejeté et régénéré. Cela réduit drastiquement le nombre de forward pass nécessaires, accélérant le decode d’un facteur significatif sans compromettre la qualité.
Sorties structurées : Vous pouvez contraindre la génération à des regex, des schémas JSON ou des grammaires EBNF. Cela signifie que le modèle ne générera jamais de sorties mal formées. Si vous demandez un JSON, vous obtenez un JSON valide. Si vous demandez un nombre entre 1 et 100, le modèle ne générera jamais 150. C’est une fonctionnalité qui simplifie énormément l’intégration dans des pipelines complexes.
Parallélisme sophistiqué : DeepInfer implémente attention data parallelism, expert parallelism pour les modèles MoE, et balanced context parallelism. Ce n’est pas un simple « divisez le batch entre les GPU ». C’est une orchestration intelligente qui comprend la structure du modèle et distribue la charge de manière optimale. Sur 64 GPU pour le decode, cela se traduit par un débit par utilisateur qui reste stable même avec des milliers de requêtes simultanées.
Planification asynchrone : Traditionnellement, le CPU prépare le batch, l’envoie au GPU, attend qu’il se termine, puis prépare le batch suivant. DeepInfer chevauche ces opérations. Pendant que le GPU traite le batch actuel, le CPU prépare déjà le suivant. Cela élimine les lacunes d’inactivité et réduit la latence end-to-end.
Comment l’essayer#
DeepInfer est disponible sur GitHub à l’adresse github.com/deepseek-ai/DeepInfer. La configuration nécessite un environnement Linux avec Python 3.12, GCC >= 13.0, et CUDA 13 (pour NVIDIA) ou CANN 9.2 (pour Ascend). Ce n’est pas une démo en un clic, mais le processus est raisonnablement direct.
Après avoir cloné le référentiel, vous créez un environnement Python 3.12 vierge, exportez la variable DEEPINFER_ACCELERATOR=nvidia (ou ascend si vous utilisez Huawei), et exécutez ./build.sh. Le système téléchargera automatiquement le checkpoint DeepSeek-V4.1-Flash depuis Hugging Face au premier lancement, ou vous pouvez pointer vers une copie locale via DEEPINFER_HF_MODEL_DIR. La documentation du référentiel inclut des exemples d’inference hors ligne et des scripts pour reproduire les benchmarks officiels sur 4 GPU pour le prefill et 64 pour le decode.
Pour ceux qui veulent approfondir, le référentiel contient également du code d’évaluation et une documentation détaillée sur la façon de configurer les diverses fonctionnalités (DSpark, batch-invariant inference, structured outputs). La communauté est active pour répondre aux questions, et le code est bien structuré pour ceux qui souhaitent contribuer ou étendre le framework.
Réflexions finales#
DeepInfer représente un moment important dans l’évolution de l’écosystème open source pour l’IA. Ce n’est pas seulement un outil, c’est la matérialisation de années de recherche et d’optimisation de la part de DeepSeek, mise à disposition de la communauté. À un moment où les modèles de langage deviennent de plus en plus grands et les demandes d’inference de plus en plus complexes, avoir accès à un framework construit pour la production réelle est précieux.
Ce qui rend ce projet particulièrement intéressant, c’est que ce n’est pas une simplification. DeepInfer maintient la complexité nécessaire pour obtenir de vraies performances, mais l’expose à travers des API raisonnables. Si vous êtes un développeur qui souhaite servir des modèles DeepSeek en production, ou un chercheur intéressé par les techniques d’optimisation pour l’inference, DeepInfer mérite d’être dans votre toolkit.
Cas d’usage#
- Private AI Stack: Intégration dans des pipelines propriétaires
- Client Solutions: Implémentation pour des projets clients
- Development Acceleration: Réduction du time-to-market des projets
Ressources#
Liens originaux#
Article signalé et sélectionné par l’équipe Human Technology eXcellence élaboré via intelligence artificielle (dans ce cas avec LLM HTX-EU-Claude-Haiku-4.5) le 2026-10-22 13:13 Source originale : https://github.com/deepseek-ai/DeepInfer
Articles Connexes#
- Pourquoi votre LLM local semble plus bête qu’il ne l’est réellement - LLM, Natural Language Processing, Transformer
- Architecture, modèles et mécanismes internes de l’agent de codage IA d’Anthropic - AI Agent, TypeScript, Reverse Engineering
- GitHub - microsoft/VibeVoice : IA vocale open-source de pointe - AI, Python, Open Source