Tipo: GitHub Repository
Link original: https://github.com/deepseek-ai/DeepInfer
Fecha de publicación: 2026-10-22
Resumen#
Introducción#
Imagina que necesitas servir miles de solicitudes simultáneas a un modelo de lenguaje masivo como DeepSeek-V4.1-Flash. No estamos hablando de un chatbot que responde a unos pocos usuarios al día, sino de un sistema en producción que debe manejar tráfico real, con latencias predecibles y throughput consistente. ¿El problema? Los frameworks de inference genéricos no están construidos para esto. Pierden tiempo valioso en overhead de scheduling, no aprovechan plenamente el hardware disponible, y luchan por mantener performance estable cuando la carga varía. DeepInfer es la respuesta que DeepSeek desarrolló internamente para abordar exactamente este problema, y ahora está disponible como proyecto open source.
DeepInfer no es un wrapper ligero alrededor de vLLM o TensorRT-LLM. Es un framework completamente optimizado, construido desde cero para extraer cada gota de performance del hardware moderno, ya sea GPU NVIDIA SM100 o NPU Huawei Ascend. Con casi 20 mil estrellas en GitHub y una comunidad activa de contribuidores, representa el estado del arte en el campo de la inference de alto rendimiento para modelos de lenguaje de gran escala.
Qué Hace#
DeepInfer es esencialmente el motor que transforma un modelo de lenguaje en un servicio de producción confiable y rápido. Toma tu modelo DeepSeek, lo carga en memoria, y lo prepara para procesar miles de tokens por segundo manteniendo latencias bajas y predecibles.
El framework gestiona dos fases críticas de la inference: el prefill (cuando procesas el prompt inicial) y el decode (cuando generas los tokens de respuesta uno por uno). Cada una de estas fases tiene dinámicas completamente diferentes, y DeepInfer las optimiza por separado. Durante el prefill, el sistema puede paralelizar masivamente el trabajo porque todos los tokens del prompt están disponibles simultáneamente. Durante el decode, en cambio, cada token depende del anterior, por lo que la optimización se concentra en latencia ultra-baja y throughput por usuario.
Lo que hace especial a DeepInfer es cómo orquesta todo esto. Utiliza kernels optimizados personalizados (FlashMLA, DeepGEMM, DeepEP), implementa paralelismo sofisticado con attention data parallelism y expert parallelism para modelos MoE, e introduce técnicas innovadoras como DSpark (draft tokens con verificación confidence-scheduled) para acelerar aún más el decode. Todo esto es coordinado por un scheduler asincrónico de cero overhead que superpone el trabajo de CPU con la ejecución de GPU, eliminando los cuellos de botella tradicionales.
Por Qué Es Extraordinario#
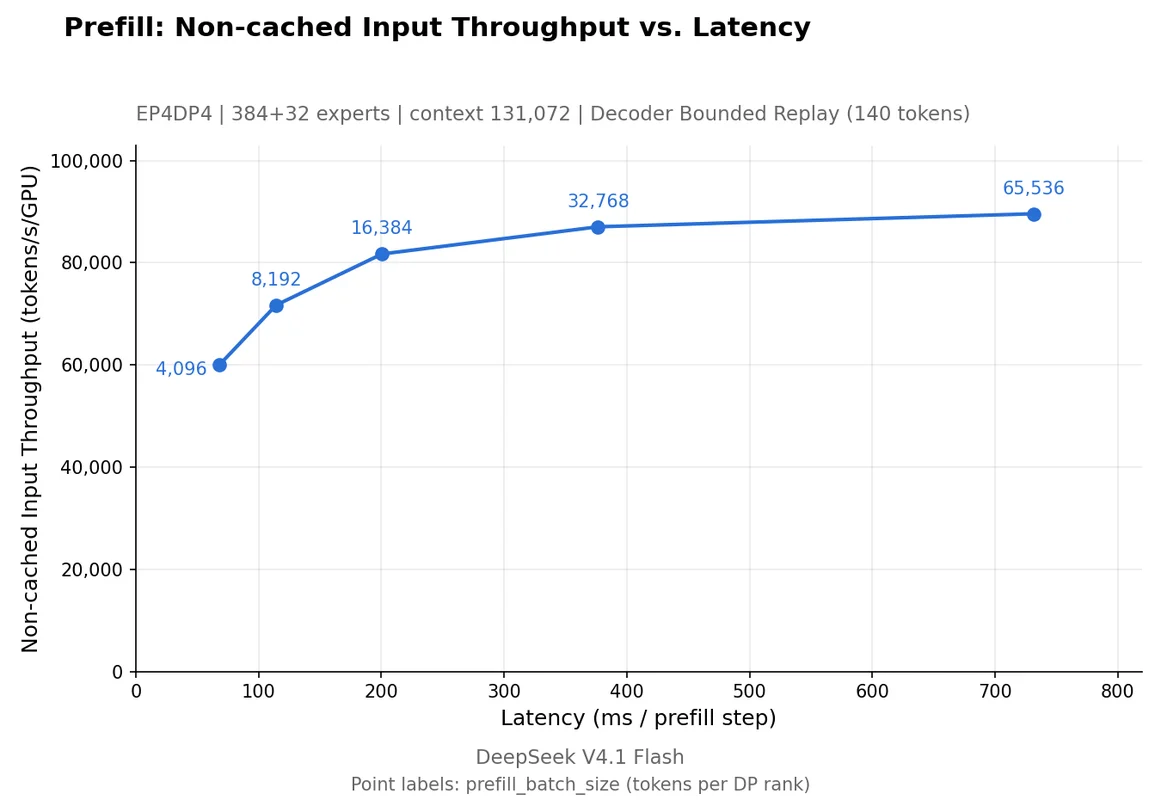
El factor “wow” de DeepInfer está en la combinación de performance bruta y confiabilidad. Los benchmarks muestran curvas Pareto impresionantes: puedes elegir si priorizar throughput máximo durante el prefill o latencia mínima para el decode, y el framework te permite navegar este trade-off de manera granular. Pero no es solo velocidad bruta.
Determinismo y reproducibilidad: Una característica a menudo subestimada pero crítica en producción. DeepInfer puede garantizar que inputs idénticos y parámetros de sampling idénticos produzcan outputs idénticos, independientemente de la composición del batch. Esto es fundamental para debugging, testing y compliance. Simplemente habilitas DEEPINFER_BATCH_INVARIANT=1 y el sistema mantiene la coherencia incluso cuando la carga varía.
Decoding inteligente con DSpark: En lugar de generar cada token secuencialmente (lento), DeepInfer genera tokens “draft” en paralelo y luego verifica si son correctos usando confidence estimates. Si la confidence es alta, el token se acepta directamente. Si es baja, se rechaza y se regenera. Esto reduce drásticamente el número de forward pass necesarios, acelerando el decode por un factor significativo sin comprometer la calidad.
Outputs estructurados: Puedes restringir la generación a regex, JSON schema o gramáticas EBNF. Esto significa que el modelo nunca generará outputs malformados. Si pides un JSON, obtienes un JSON válido. Si pides un número entre 1 y 100, el modelo nunca generará 150. Es una feature que simplifica enormemente la integración en pipelines complejos.
Paralelismo sofisticado: DeepInfer implementa attention data parallelism, expert parallelism para modelos MoE, y balanced context parallelism. No es un simple “divide el batch entre GPUs”. Es una orquestación inteligente que entiende la estructura del modelo y distribuye la carga de manera óptima. En 64 GPUs para el decode, esto se traduce en throughput por usuario que permanece estable incluso con miles de solicitudes simultáneas.
Scheduling asincrónico: Tradicionalmente, la CPU prepara el batch, lo envía a la GPU, espera a que termine, luego prepara el siguiente batch. DeepInfer superpone estas operaciones. Mientras la GPU procesa el batch actual, la CPU ya está preparando el siguiente. Esto elimina los gaps de inactividad y reduce la latencia end-to-end.
Cómo Probarlo#
DeepInfer está disponible en GitHub en github.com/deepseek-ai/DeepInfer. El setup requiere un entorno Linux con Python 3.12, GCC >= 13.0, y CUDA 13 (para NVIDIA) o CANN 9.2 (para Ascend). No es una demo one-click, pero el proceso es razonablemente directo.
Después de clonar el repositorio, creas un entorno Python 3.12 vacío, exportas la variable DEEPINFER_ACCELERATOR=nvidia (o ascend si usas Huawei), y ejecutas ./build.sh. El sistema descargará automáticamente el checkpoint DeepSeek-V4.1-Flash desde Hugging Face en el primer inicio, o puedes apuntar a una copia local vía DEEPINFER_HF_MODEL_DIR. La documentación en el repositorio incluye ejemplos de inference offline y scripts para reproducir los benchmarks oficiales en 4 GPUs para el prefill y 64 para el decode.
Para quienes quieran profundizar, el repositorio también contiene código de evaluation y documentación detallada sobre cómo configurar las diversas features (DSpark, batch-invariant inference, structured outputs). La comunidad es activa respondiendo preguntas, y el código está bien estructurado para quienes quieran contribuir o extender el framework.
Consideraciones Finales#
DeepInfer representa un momento importante en la evolución del ecosistema open source para AI. No es solo una herramienta, es la materialización de años de investigación y optimización por parte de DeepSeek, puesta a disposición de la comunidad. En un momento en que los modelos de lenguaje se están volviendo cada vez más grandes y las solicitudes de inference cada vez más complejas, tener acceso a un framework construido para producción real es valioso.
Lo que hace este proyecto particularmente interesante es que no es una simplificación. DeepInfer mantiene la complejidad necesaria para obtener performance real, pero la expone a través de APIs razonables. Si eres un desarrollador que quiere servir modelos DeepSeek en producción, o un investigador interesado en técnicas de optimización para inference, DeepInfer merece estar en tu toolkit.
Casos de Uso#
- Private AI Stack: Integración en pipelines propietarios
- Client Solutions: Implementación para proyectos de clientes
- Development Acceleration: Reducción del time-to-market en proyectos
Recursos#
Links Originales#
Artículo reportado y seleccionado por el equipo Human Technology eXcellence procesado mediante inteligencia artificial (en este caso con LLM HTX-EU-Claude-Haiku-4.5) el 2026-10-22 13:13 Fuente original: https://github.com/deepseek-ai/DeepInfer
Artículos Relacionados#
- Por qué tu LLM local parece más tonto de lo que realmente es - LLM, Natural Language Processing, Transformer
- GitHub - alexziskind1/llama-throughput-lab: Lanzador interactivo y arnés de referencia para el rendimiento del servidor llama.cpp, con pruebas, barridos y herramientas de carga en ronda. - Open Source, Python
- GitHub - HandsOnLLM/Hands-On-Large-Language-Models: Repositorio oficial de código para el libro de O’Reilly - ‘Hands-On Large Language Models’ - LLM, Open Source, Foundation Model