Typ: GitHub Repository
Originallink: https://github.com/deepseek-ai/DeepInfer
Veröffentlichungsdatum: 2026-10-22
Zusammenfassung#
Einleitung#
Stellen Sie sich vor, Sie müssen Tausende gleichzeitiger Anfragen an ein großes Sprachmodell wie DeepSeek-V4.1-Flash verarbeiten. Wir sprechen nicht von einem Chatbot, der täglich ein paar Benutzer bedient, sondern von einem Produktionssystem, das echten Traffic bewältigen muss, mit vorhersehbaren Latenzen und konsistentem Durchsatz. Das Problem? Generische Inference-Frameworks sind nicht dafür ausgelegt. Sie verschwenden wertvolle Zeit durch Scheduling-Overhead, nutzen die verfügbare Hardware nicht vollständig aus und haben Schwierigkeiten, stabile Performance bei variierender Last zu halten. DeepInfer ist die Antwort, die DeepSeek intern entwickelt hat, um genau dieses Problem zu lösen, und ist nun als Open-Source-Projekt verfügbar.
DeepInfer ist kein leichter Wrapper um vLLM oder TensorRT-LLM. Es ist ein vollständig optimiertes Framework, von Grund auf für die Extraktion jedes Tropfens Performance aus moderner Hardware gebaut, sei es NVIDIA SM100 GPUs oder Huawei Ascend NPUs. Mit fast 20.000 Stars auf GitHub und einer aktiven Contributor-Community repräsentiert es den Stand der Technik im Bereich hochperformanter Inference für große Sprachmodelle.
Was es macht#
DeepInfer ist im Grunde der Motor, der ein Sprachmodell in einen zuverlässigen und schnellen Produktionsdienst umwandelt. Es nimmt Ihr DeepSeek-Modell, lädt es in den Speicher und bereitet es vor, um Tausende von Token pro Sekunde zu verarbeiten und dabei niedrige und vorhersehbare Latenzen zu halten.
Das Framework verwaltet zwei kritische Phasen der Inference: das Prefill (wenn Sie den initialen Prompt verarbeiten) und das Decode (wenn Sie die Antwort-Token nacheinander generieren). Jede dieser Phasen hat völlig unterschiedliche Dynamiken, und DeepInfer optimiert sie separat. Während des Prefill kann das System die Arbeit massiv parallelisieren, da alle Prompt-Token gleichzeitig verfügbar sind. Während des Decode hängt jeder Token vom vorherigen ab, daher konzentriert sich die Optimierung auf Ultra-Low-Latency und Durchsatz pro Benutzer.
Was DeepInfer besonders macht, ist die Art und Weise, wie es alles orchestriert. Es nutzt benutzerdefinierte optimierte Kernel (FlashMLA, DeepGEMM, DeepEP), implementiert ausgefeilten Parallelismus mit Attention Data Parallelism und Expert Parallelism für MoE-Modelle und führt innovative Techniken wie DSpark (Draft-Tokens mit Confidence-Scheduled-Verifikation) ein, um das Decode weiter zu beschleunigen. Alles wird von einem asynchronen Scheduler mit Null-Overhead koordiniert, der CPU-Arbeit mit GPU-Ausführung überlagert und traditionelle Engpässe eliminiert.
Warum es besonders ist#
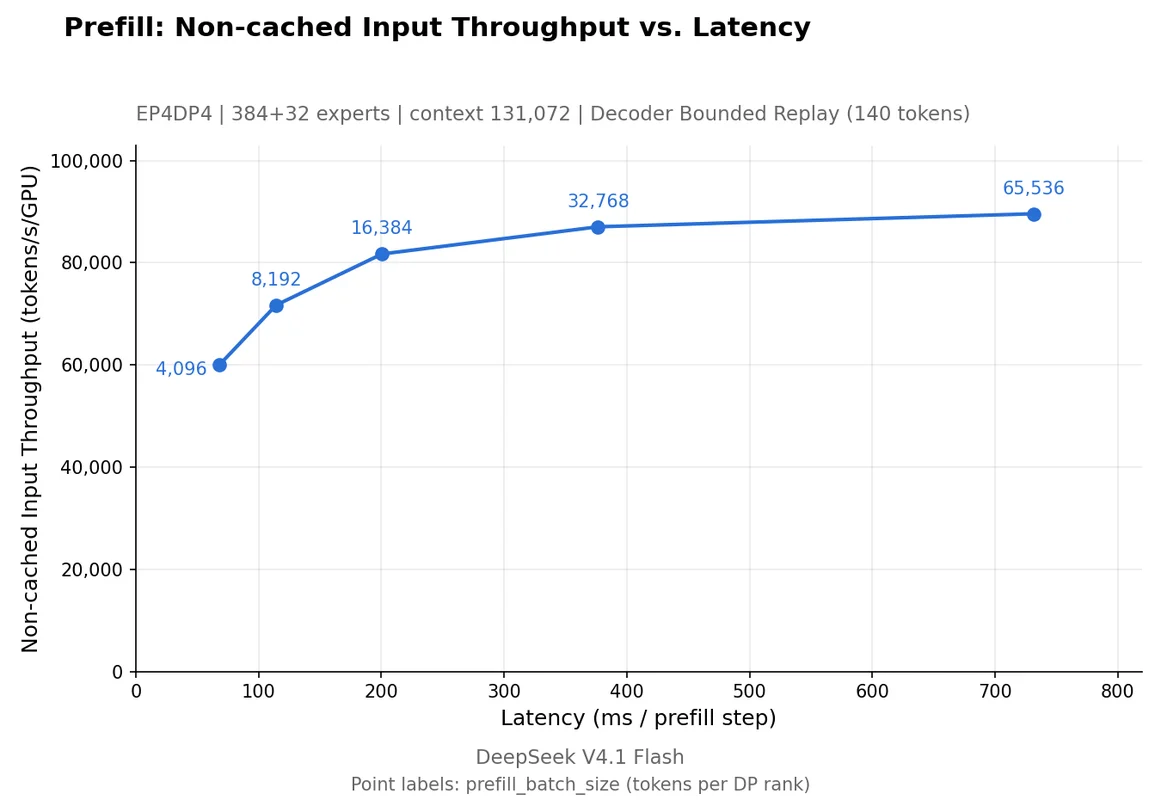
Der “Wow”-Faktor von DeepInfer liegt in der Kombination aus roher Performance und Zuverlässigkeit. Benchmarks zeigen beeindruckende Pareto-Kurven: Sie können wählen, ob Sie maximalen Durchsatz während des Prefill oder minimale Latenz für das Decode priorisieren, und das Framework ermöglicht es Ihnen, diesen Trade-off granular zu navigieren. Aber es ist nicht nur rohe Geschwindigkeit.
Determinismus und Reproduzierbarkeit: Ein oft unterschätztes, aber in der Produktion kritisches Merkmal. DeepInfer kann garantieren, dass identische Eingaben und Sampling-Parameter identische Ausgaben erzeugen, unabhängig von der Batch-Zusammensetzung. Dies ist grundlegend für Debugging, Testing und Compliance. Sie aktivieren einfach DEEPINFER_BATCH_INVARIANT=1 und das System behält Konsistenz, auch wenn die Last variiert.
Intelligentes Decoding mit DSpark: Anstatt jeden Token sequenziell zu generieren (langsam), generiert DeepInfer “Draft”-Token parallel und verifiziert dann, ob sie korrekt sind, indem es Confidence-Estimates verwendet. Wenn das Confidence hoch ist, wird der Token direkt akzeptiert. Wenn es niedrig ist, wird er abgelehnt und neu generiert. Dies reduziert drastisch die Anzahl der erforderlichen Forward-Passes und beschleunigt das Decode um einen signifikanten Faktor, ohne die Qualität zu beeinträchtigen.
Strukturierte Ausgaben: Sie können die Generierung auf Regex, JSON-Schema oder EBNF-Grammatiken beschränken. Das bedeutet, dass das Modell niemals fehlerhaft formatierte Ausgaben generiert. Wenn Sie JSON anfordern, erhalten Sie gültiges JSON. Wenn Sie eine Zahl zwischen 1 und 100 anfordern, generiert das Modell niemals 150. Es ist eine Funktion, die die Integration in komplexe Pipelines erheblich vereinfacht.
Ausgefeilter Parallelismus: DeepInfer implementiert Attention Data Parallelism, Expert Parallelism für MoE-Modelle und Balanced Context Parallelism. Es ist nicht einfach “teile den Batch zwischen GPUs auf”. Es ist eine intelligente Orchestrierung, die die Struktur des Modells versteht und die Last optimal verteilt. Auf 64 GPUs für das Decode führt dies zu Durchsatz pro Benutzer, der auch bei Tausenden gleichzeitiger Anfragen stabil bleibt.
Asynchrones Scheduling: Traditionell bereitet die CPU den Batch vor, sendet ihn an die GPU, wartet auf das Ergebnis und bereitet dann den nächsten Batch vor. DeepInfer überlagert diese Operationen. Während die GPU den aktuellen Batch verarbeitet, bereitet die CPU bereits den nächsten vor. Dies eliminiert Inaktivitätslücken und reduziert die End-to-End-Latenz.
Wie man es ausprobiert#
DeepInfer ist auf GitHub unter github.com/deepseek-ai/DeepInfer verfügbar. Das Setup erfordert eine Linux-Umgebung mit Python 3.12, GCC >= 13.0 und CUDA 13 (für NVIDIA) oder CANN 9.2 (für Ascend). Es ist keine One-Click-Demo, aber der Prozess ist relativ unkompliziert.
Nach dem Klonen des Repositories erstellen Sie eine leere Python-3.12-Umgebung, exportieren die Variable DEEPINFER_ACCELERATOR=nvidia (oder ascend wenn Sie Huawei verwenden) und führen ./build.sh aus. Das System lädt automatisch den DeepSeek-V4.1-Flash-Checkpoint von Hugging Face beim ersten Start herunter, oder Sie können auf eine lokale Kopie über DEEPINFER_HF_MODEL_DIR verweisen. Die Dokumentation im Repository enthält Beispiele für Offline-Inference und Skripte zur Reproduktion der offiziellen Benchmarks auf 4 GPUs für das Prefill und 64 für das Decode.
Für diejenigen, die tiefer einsteigen möchten, enthält das Repository auch Evaluierungscode und detaillierte Dokumentation zur Konfiguration der verschiedenen Funktionen (DSpark, Batch-Invariant-Inference, strukturierte Ausgaben). Die Community ist aktiv bei der Beantwortung von Fragen, und der Code ist gut strukturiert für diejenigen, die zum Framework beitragen oder ihn erweitern möchten.
Abschließende Gedanken#
DeepInfer stellt einen wichtigen Moment in der Entwicklung des Open-Source-Ökosystems für AI dar. Es ist nicht nur ein Tool, es ist die Materialisierung von Jahren Forschung und Optimierung durch DeepSeek, der der Community zur Verfügung gestellt wird. In einer Zeit, in der Sprachmodelle immer größer werden und die Anforderungen an Inference immer komplexer, ist der Zugang zu einem für echte Produktion gebauten Framework wertvoll.
Was dieses Projekt besonders interessant macht, ist, dass es keine Vereinfachung ist. DeepInfer behält die notwendige Komplexität, um echte Performance zu erreichen, exponiert sie aber durch vernünftige APIs. Wenn Sie ein Entwickler sind, der DeepSeek-Modelle in der Produktion bereitstellen möchte, oder ein Forscher, der sich für Optimierungstechniken bei Inference interessiert, verdient DeepInfer einen Platz in Ihrem Toolkit.
Anwendungsfälle#
- Private AI Stack: Integration in proprietäre Pipelines
- Client Solutions: Implementierung für Kundenprojekte
- Development Acceleration: Verkürzung der Time-to-Market für Projekte
Ressourcen#
Originallinks#
Artikel gemeldet und vom Human Technology eXcellence Team ausgewählt, verarbeitet mit künstlicher Intelligenz (in diesem Fall mit LLM HTX-EU-Claude-Haiku-4.5) am 2026-10-22 13:13 Originalquelle: https://github.com/deepseek-ai/DeepInfer
Verwandte Artikel#
- GitHub - chiennv2000/orthrus: Schneller, verlustfreier LLM-Inferenz durch… - Python, LLM, Open Source
- GitHub - HandsOnLLM/Hands-On-Large-Language-Models: Offizielles Code-Repository für das O’Reilly-Buch - ‘Hands-On Large Language Models’ - LLM, Open Source, Foundation Model
- GitHub - microsoft/VibeVoice: Open-Source Frontier Voice KI - AI, Python, Open Source